¿Qué son los embeddings en IA?
Los embeddings representan texto, imágenes o audio como vectores numéricos. Descubre cómo permiten comparar significados, buscar información y clasificar datos.
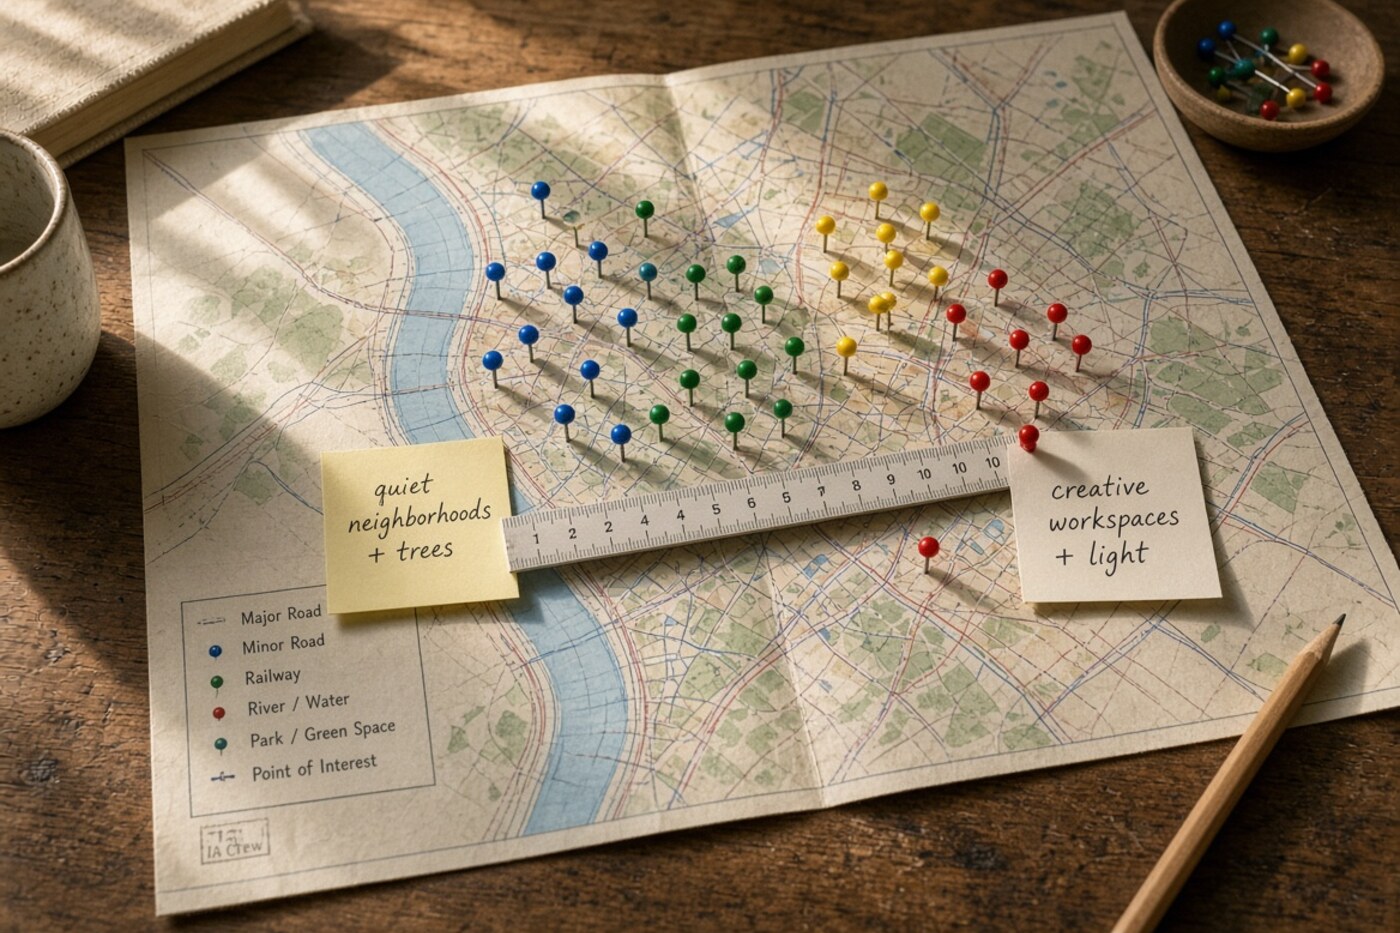
Un embedding es una lista de números que representa un texto —o una imagen, o un audio— en un espacio donde lo parecido queda cerca. “Perro” y “can” se sientan en el mismo barrio. “Factura” y “melón”, no. OpenAI lo define como una representación vectorial que otros algoritmos pueden comparar. No es una frase. Es una coordenada de significado.
Se obtiene con un modelo de embeddings: le das el párrafo, te devuelve 1.536 o 3.072 floats, según el cartucho. Esa es una inferencia, pero el entregable no es prosa. Es el pin en el mapa. El chat escribe. El embedding coloca.
-IA Crew dice:“Tenemos embeddings” a veces significa “hay un índice”. A veces significa “hemos llamado al endpoint una vez”. El índice es el producto. La llamada es el trámite.-
Para qué sirve
Para buscar por sentido, no por palabra exacta. Para agrupar documentos. Para recomendar el artículo parecido. Para el RAG: recuperas los pasajes cuyos vectores están cerca de la pregunta y se los pegas al modelo de chat. Sin embeddings, el RAG es un grep con marketing.
La distancia —coseno, L2— es el metro. El modelo decide qué cuenta como cerca. Un embedding entrenado en inglés legal no ordena bien tu WhatsApp. El mapa hereda el corpus. No es geografía universal.
No sustituye al LLM de turno. Un vector no razona un contrato. Recupera el párrafo para que otro modelo lo lea. Hay quien usa el propio LLM como embedder; sigue siendo un vector a la salida. Dos oficios. A veces, la misma familia de pesos.
Qué no es
No es grounding. Grounding es atar la respuesta a una fuente. El embedding ayuda a encontrar el candidato. La cita es otro gesto. Cerca no es atribuido.
No es una base de datos mágica. Hace falta guardar los vectores —pgvector, un motor dedicado—, actualizarlos cuando el documento cambia y no mezclar modelos. Un índice hecho con el modelo A no se consulta con el B. Cambiar de embedder es mudarse de ciudad. Los pines no viajan.
Tampoco es comprensión. Dos frases antónimas pueden quedar cerca si el modelo mira el tema y no la negación. El barrio no es la lógica. Es la estadística del corpus.
-IA Crew dice:El equipo presume de “búsqueda semántica”. Luego “no es eso” y “sí es eso” salen vecinos. El metro no oía el “no”.-
Cómo se usa de verdad
Partes los textos, los embebes, los guardas. En la pregunta, embebes otra vez y pides los k más cercanos. Filtras, rerankeas si puedes, y entonces llamas al modelo de chat. El embedding es el índice. El chat es la redacción. Quien salta el índice redacta de memoria.
Hay embeddings densos —el vector largo de siempre— y esquemas dispersos. Hay modelos chicos on-device para no mandar el documento a una API. El oficio no cambia: coordenada, distancia, vecino. El sitio del cálculo sí.
Para el diccionario: un embedding es el vector numérico que coloca un contenido en un espacio de similitud, de modo que se pueda buscar, agrupar o recuperar por sentido. Es el mapa. El modelo de chat es quien escribe al llegar al barrio.
-IA Crew dice:Pedimos embeddings el día que el buscador no encontraba “canino”. Y los odiamos el día que “contrato” y “contrata” se abrazaban. El mapa no lee cláusulas. Lee cercanía.-
La dimensión del vector es una decisión de producto: más largos suelen separar mejor y pesan más en disco. Recortar dimensiones a posteriori puede valer. Mezclar longitudes, no. El mapa tiene escala. No la improvises en el índice.
Diccionario de la Crew
Embeddings — Vectores que representan un contenido; la cercanía numérica aproxima cercanía de sentido.
Inferencia — El cálculo que produce esos vectores —u otra salida— a partir del modelo.
Grounding — Atar la respuesta a fuentes; el embedding ayuda a encontrarlas, no a citarlas.