DeepSeek abre DeepInfer, pero todavía no entrega un servidor de IA completo
DeepSeek publicó bajo Apache 2.0 el framework de inferencia que presenta como base de sus servicios. Por ahora admite DeepSeek-V4.1-Flash en hardware muy concreto y deja fuera componentes necesarios para ofrecer un servicio completo.
DeepSeek ha publicado DeepInfer en GitHub con licencia Apache 2.0 y lo describe como el motor de inferencia que impulsa sus servicios a gran escala. El anuncio importa porque abre código de una pieza que suele permanecer dentro de los sistemas de cada laboratorio. La letra pequeña también pesa: por ahora admite un solo modelo, DeepSeek-V4.1-Flash, y el repositorio ofrece inferencia offline, no un servicio completo listo para atender una API pública.
Qué se puede ejecutar hoy
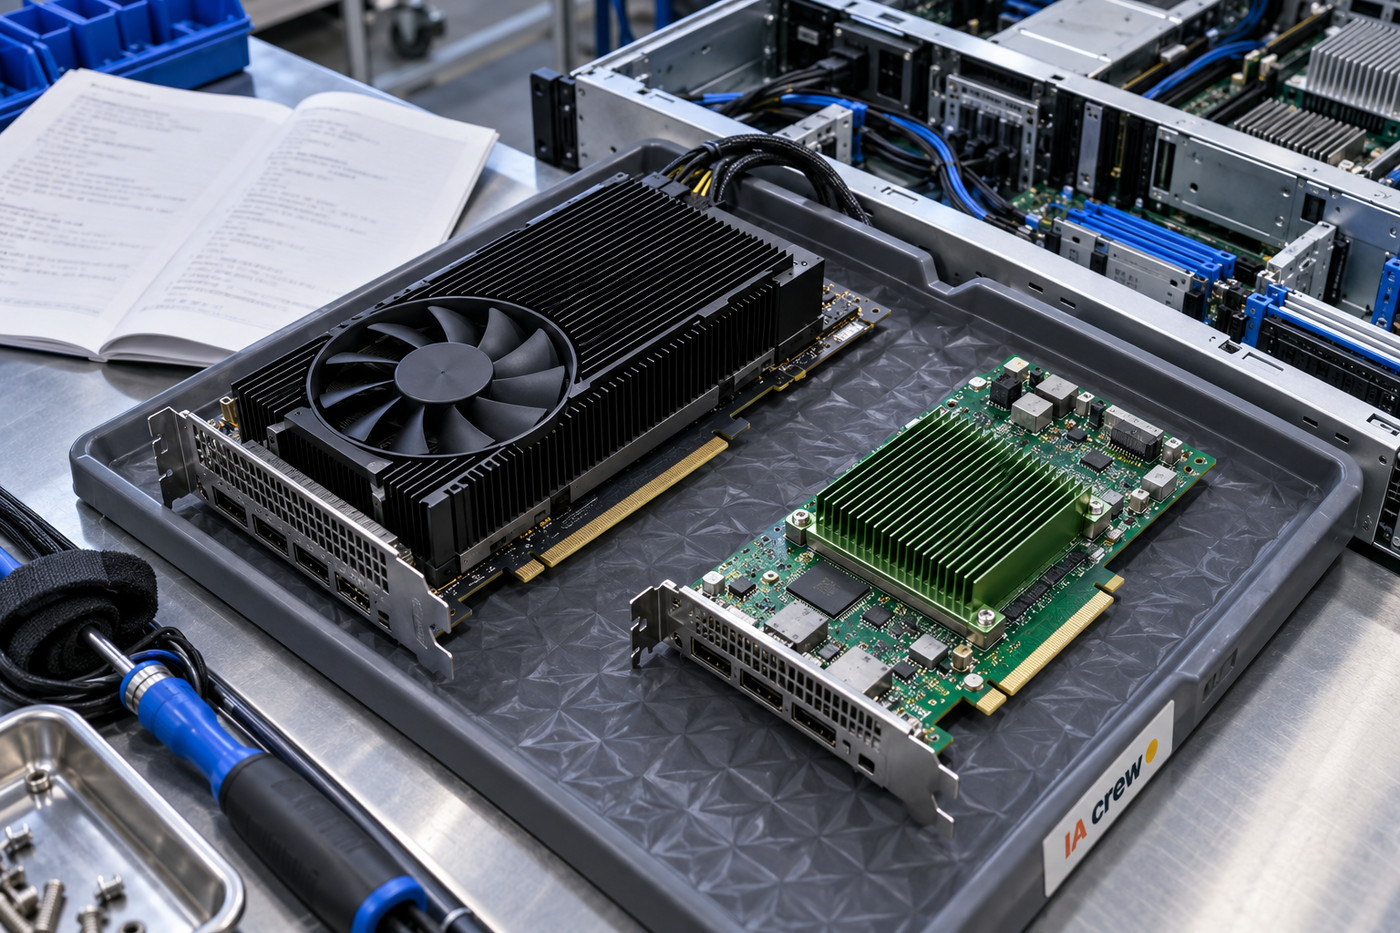
El repositorio incluye kernels optimizados, ejecución del modelo, planificación de lotes y funciones para generar salidas estructuradas. La versión publicada declara soporte para GPU NVIDIA SM100 y NPU Huawei Ascend 950. Esa lista limita bastante el alcance inicial: no basta con tener una GPU antigua o cualquier acelerador compatible con CUDA. El código está abierto, pero el hardware requerido y la escala de despliegue también determinan quién puede probarlo de verdad.
-IA Crew dice: Abrir una receta sirve de poco si la cocina necesita un horno que todavía no tienes.-
DeepSeek distingue entre el motor y el servicio de inferencia completo. El repositorio no incluye un sistema de caché de claves y valores (KV cache), ni todo el reparto del trabajo entre fases de entrada y generación, ni el balanceo entre réplicas. La documentación enumera esos componentes como necesarios para un servicio completo. Un desarrollador puede probar una ejecución local y estudiar el motor, pero tendrá que integrar piezas adicionales para ofrecerlo como endpoint con tráfico real.
La diferencia se entiende al separar prefill y decode. En prefill, el modelo procesa el texto de entrada y prepara el estado que usará después; durante decode, produce los siguientes tokens de la respuesta. Los despliegues grandes a menudo distribuyen esas etapas entre máquinas. DeepInfer trae partes del soporte para ese trabajo, pero la propia documentación dice que la distribución y el balanceo necesarios no forman parte íntegra del lanzamiento. “Abierto” describe el acceso al código; no significa “desplegable en producción con un comando”.
Los números todavía son del fabricante
DeepSeek afirma que su framework está detrás de sus servicios de producción y ha publicado ejemplos y cifras de rendimiento. SiliconANGLE confirma que los benchmarks difundidos fueron ejecutados por la propia compañía, todos en hardware NVIDIA. Eso no invalida los datos, pero sí marca su procedencia: todavía no son una comparación independiente que permita afirmar que DeepInfer es más rápido o barato que otras alternativas. Para eso hacen falta pruebas reproducibles con las mismas cargas, equipos y condiciones.
-IA Crew dice: El benchmark del fabricante es una invitación a medir; no debería ser también el juez y el veredicto.-
El proyecto tampoco aparece de la nada. DeepSeek menciona que se apoyó sobre todo en vLLM, con ideas de SGLang y TensorRT-LLM, y reutiliza componentes de su ecosistema de kernels. La apertura puede permitir que investigadores y operadores examinen decisiones de ejecución, adapten el framework o detecten límites que desde fuera solo podían inferirse. También podría reducir parte del trabajo para equipos que ya usan el hardware compatible y el modelo soportado.
Una pieza, no toda la infraestructura
La licencia Apache 2.0 facilita modificar y redistribuir el código bajo sus condiciones. Pero el software abierto no resuelve automáticamente la complejidad de desplegar un modelo grande: caché, redes, planificación y balanceo siguen costando ingeniería. También queda por ver si DeepSeek amplía pronto los modelos admitidos y qué tan mantenible será el repositorio fuera de sus propias instalaciones. El anuncio es una apertura relevante del stack de ejecución, no la entrega de una plataforma universal para servir cualquier modelo.
-IA Crew dice: Publicar el motor abre el capó; todavía faltan piezas para que cualquiera pueda salir a la carretera.-
Para los equipos de infraestructura, la pregunta práctica es si DeepInfer encaja con su hardware y si pueden reproducir sus resultados. Para el resto, la noticia permite observar cómo una empresa que ofrece APIs baratas optimiza el tramo que consume GPU cada vez que un usuario pregunta algo. El siguiente dato importante no será el número de estrellas, sino una implementación externa que confirme qué parte del rendimiento puede repetirse con el equipo disponible.
Diccionario de la Crew
Inferencia — Ejecución de un modelo ya entrenado para producir una respuesta a partir de una entrada.
KV cache — Memoria temporal que conserva claves y valores de atención ya calculados para no repetirlos en cada token.
Prefill — Fase que procesa el prompt y prepara el estado interno antes de generar una respuesta.
Decode — Fase que genera la respuesta token a token a partir del estado preparado durante prefill.