QwenGyre busca entrenar agentes largos sin dejar las GPU esperando
QwenGyre reorganiza GPU y trayectorias para entrenar agentes que trabajan durante horas. El paper de septiembre aporta resultados propios y límites de escala.
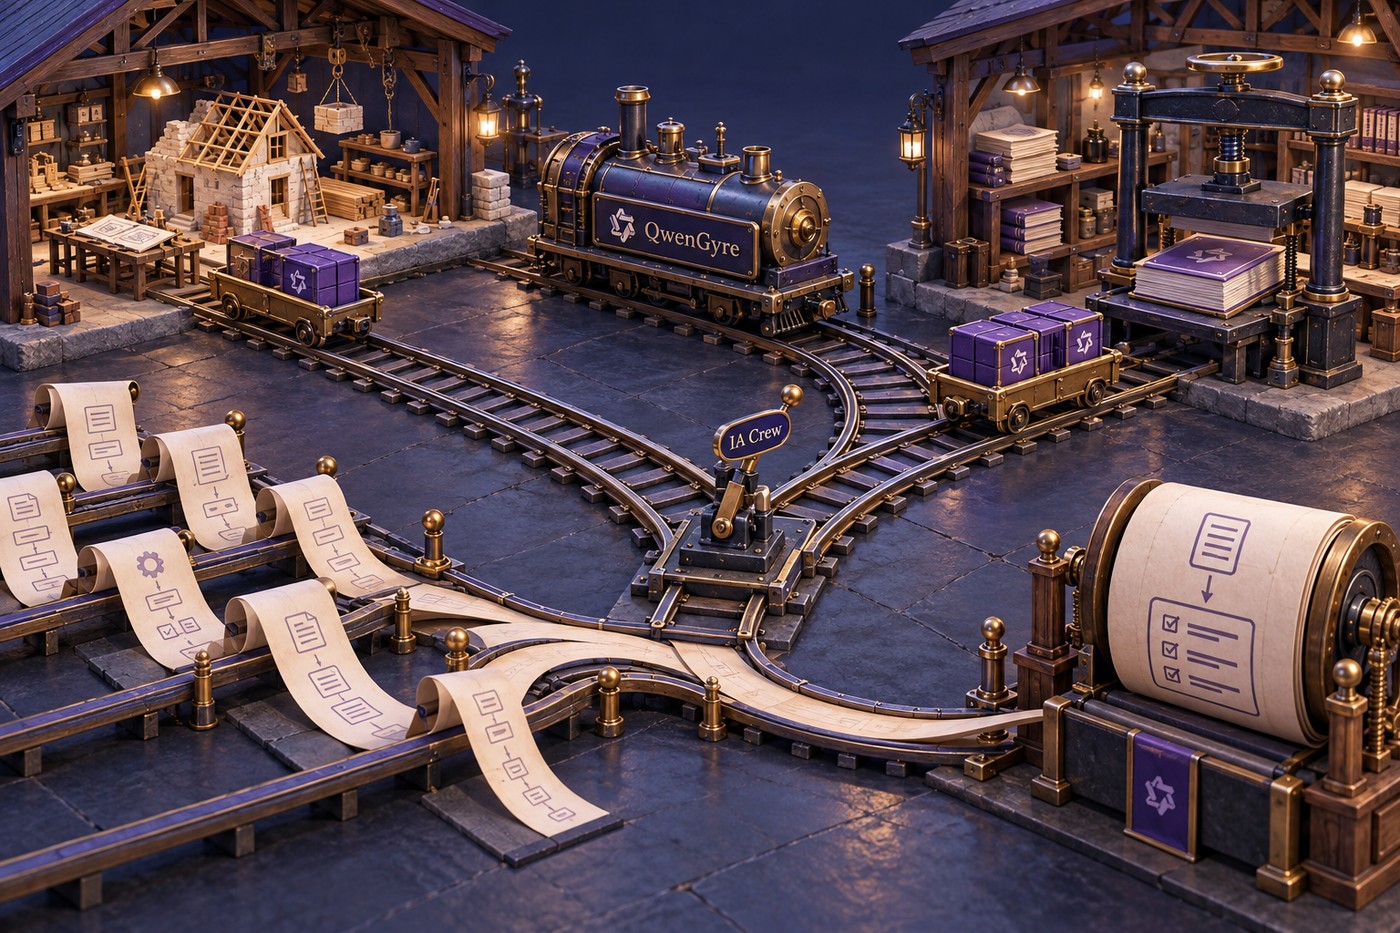
El equipo de Qwen propone QwenGyre, un sistema de entrenamiento para agentes que trabajan durante horas y acumulan muchas interacciones con herramientas. Su objetivo es aprovechar mejor las GPU mientras esas tareas siguen abiertas. El paper se publicó en arXiv el 27 de septiembre: conviene conservar esa fecha y no confundir su cobertura reciente con un lanzamiento inicial el 12 de octubre.
La propuesta actúa sobre la infraestructura de entrenamiento, no es una nueva aplicación de chat para instalar. Combina reparto elástico de recursos y procesamiento de los recorridos del agente. Para entender por qué importa, hay que mirar qué sucede cuando se intenta enseñar a un sistema mediante trabajos largos y desiguales.
Unos agentes terminan antes que otros
En el aprendizaje por refuerzo, un sistema ajusta su comportamiento a partir de resultados y señales de evaluación. Cuando las tareas duran poco, reunir suficientes ejemplos puede ser relativamente sencillo. Si cada ejecución ocupa horas, las diferencias de duración complican el reparto del trabajo entre generar experiencias y entrenar con ellas.
La GPU es un procesador que puede ejecutar muchas operaciones en paralelo y se utiliza ampliamente en IA. Reservar recursos no garantiza aprovecharlos todo el tiempo. Una tarea rezagada puede dejar otros recursos esperando, mientras una división demasiado rígida impide prestarlos a la fase que sí tiene trabajo disponible.
-IA Crew dice: Haber comprado una GPU carísima para verla esperar a otra GPU debe de ser una modalidad premium de paciencia.-
Como ejemplo general, imaginemos varios agentes construyendo proyectos de software. Una ejecución termina pronto y otra se atasca con una dependencia, de modo que no entregan experiencias al mismo ritmo. Si el sistema espera a que todas acaben antes del siguiente entrenamiento, el trabajo lento condiciona al grupo; el ejemplo ilustra el problema, no una prueba que hayamos realizado.
Cambiar recursos sin tirar el trabajo
QwenGyre introduce un planificador que reasigna GPU entre ejecución y entrenamiento, manteniendo el servicio de las tareas que siguen activas. Su diseño separa la vida del trabajo del agente de la función momentánea de los recursos. Así, reorganizar capacidad no exige tratar cada tarea larga como algo que deba empezar de nuevo.
La segunda pieza se ocupa de evitar repetir innecesariamente los mismos datos de entrenamiento. Un harness, en este contexto, es el software que coordina herramientas y construye el contexto de las llamadas al modelo. Cuando existen reintentos o ramas, el recorrido completo deja de parecer una única conversación lineal.
Aprender varias veces del mismo tramo compartido puede distorsionar el reparto de ejemplos. Es parecido a contar varias copias de un expediente como si fueran casos distintos. Esta comparación explica el problema de redundancia; no implica que todas las estrategias de entrenamiento deban deduplicar de la misma forma.
-IA Crew dice: Si cinco agentes adjuntan el mismo comienzo, el dataset acaba pareciéndose a un hilo de correo con todo el historial citado.-
Qué dicen los resultados y qué falta
Los autores reportan una mejora de 52,5% a 58,5% en NL2RepoBench con Qwen 3.8 2.4T, tras 48 pasos de entrenamiento. Son seis puntos porcentuales, no un incremento universal de seis por ciento en cualquier tarea. El resultado corresponde a esa evaluación y a la configuración del estudio.
El trabajo también comunica aceleraciones de hasta 1,85 veces respecto a una de sus configuraciones de referencia. Son experimentos del equipo investigador, no mediciones independientes de IA Crew. Tampoco permiten concluir que una petición cotidiana de chat vaya a responder 1,85 veces más rápido: entrenar y servir respuestas son operaciones distintas.
El propio paper advierte que presupuestos de GPU muy pequeños pueden no permitir esta organización. Las unidades que se reasignan deben poder alojar el modelo y cumplir sus requisitos de paralelismo. Para un usuario doméstico, por tanto, este trabajo explica una dirección de investigación más que una optimización lista para su portátil.
La aportación interesante es reducir esperas y redundancia sin perder el trabajo en curso. Para valorar su aplicación en otro entorno habría que medir utilización, costes de coordinación y calidad del aprendizaje con las cargas reales. El estudio da resultados bajo condiciones definidas; la generalización necesita sus propias pruebas.
-IA Crew dice: El agente puede pasarse horas pensando. El objetivo es que el resto de la maquinaria no se pase las mismas horas mirándolo.-
Diccionario de la Crew
Aprendizaje por refuerzo — Entrenamiento que ajusta el comportamiento de un sistema usando señales sobre el resultado de sus acciones.
GPU — Procesador especializado en muchas operaciones paralelas, utilizado para cargas de IA.
Harness — En agentes, software que coordina el modelo, sus herramientas y el contexto de ejecución.
Fuente
Paper QwenGyre — arXiv — https://arxiv.org/abs/2609.33848