Qué es una TPU y en qué se diferencia de una GPU
Una TPU es un acelerador diseñado por Google para aprendizaje automático. La comparamos con una GPU por arquitectura, software, rendimiento y coste.
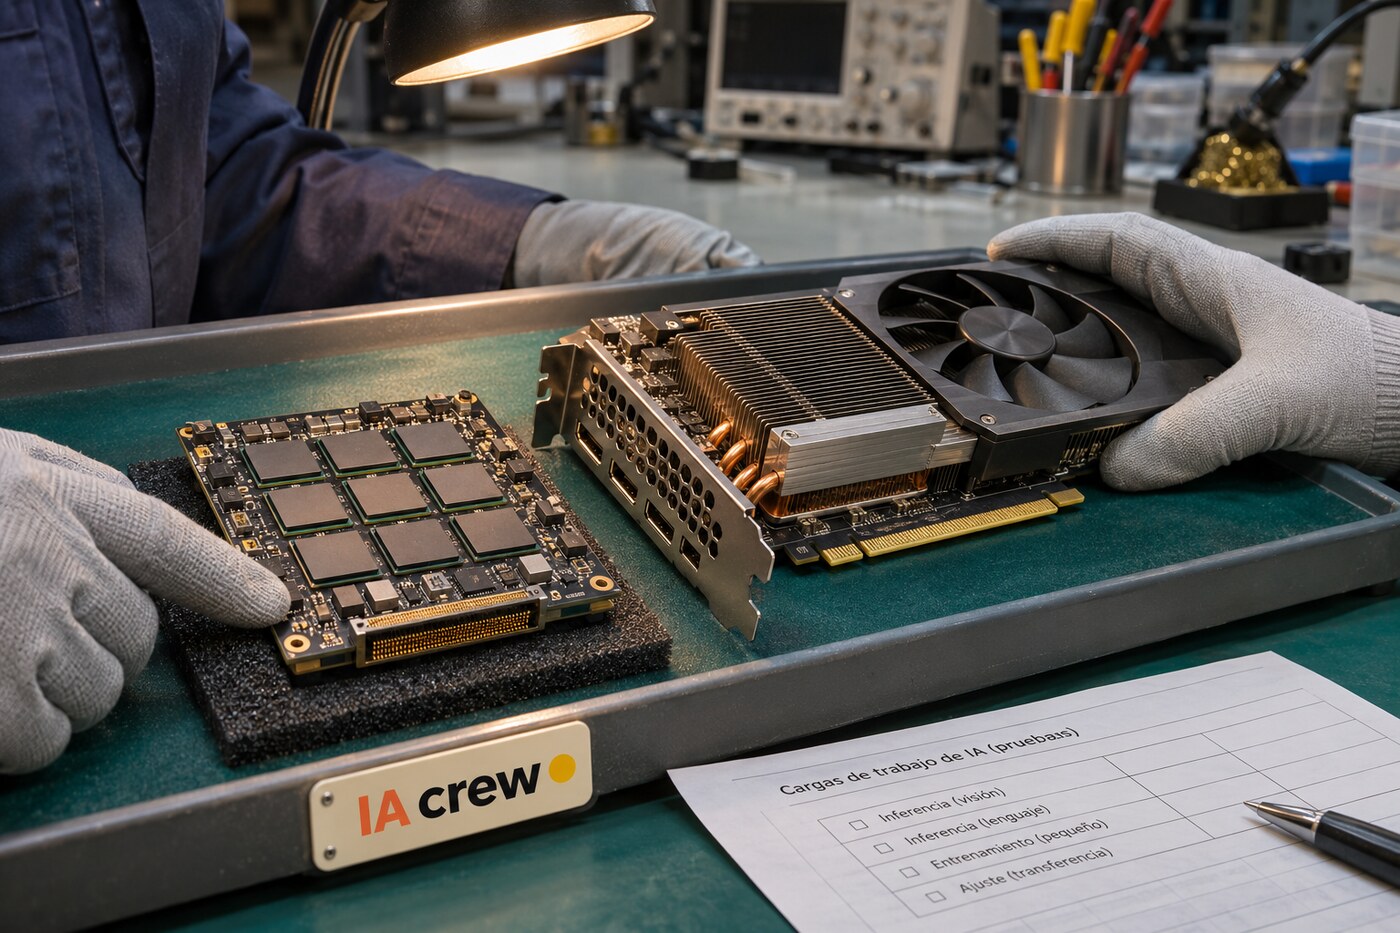
Una TPU (Tensor Processing Unit) es un ASIC, un circuito integrado diseñado por Google para acelerar cargas de aprendizaje automático, sobre todo operaciones matriciales que aparecen en redes neuronales. Una GPU también ejecuta ese tipo de trabajo en paralelo, pero parte de una tradición de procesador gráfico programable y tiene un ecosistema de uso más amplio. La diferencia práctica depende del modelo, el software y dónde se vaya a desplegar.
Dos diseños con prioridades distintas
Google describe sus TPU como aceleradores especializados para operaciones de matrices y tensores. En las generaciones actuales, cada TensorCore incluye unidades de multiplicación de matrices y unidades vectoriales y escalares; cada MXU puede organizarse como un arreglo sistólico, donde los datos fluyen entre muchas operaciones. La arquitectura cambia entre generaciones, así que “una TPU” no identifica una sola configuración ni una cifra de rendimiento fija.
Una GPU agrupa muchos elementos de procesamiento que ejecutan tareas paralelas y mantienen una jerarquía de memoria. Aunque nació para gráficos, hoy también se usa en ciencia, simulación, vídeo y redes neuronales. En las GPU de NVIDIA, los Tensor Cores aceleran determinados cálculos de matrices; por tanto, la comparación no es “TPU especializada frente a GPU incapaz de IA”, sino dos familias de aceleradores con diseños y herramientas diferentes.
-IA Crew dice: Una GPU ya no necesita disculparse por no ser una TPU. Lleva años haciendo multiplicaciones matriciales; solo tiene más trabajos en el currículum.-
El software también forma parte del chip
El hardware ejecuta código preparado por un compilador y bibliotecas. En Cloud TPU, XLA compila partes del grafo matemático del modelo y optimiza su distribución para la arquitectura. Google documenta compatibilidad con marcos como JAX y PyTorch, aunque el rendimiento puede depender de la forma de los tensores, el tamaño de los lotes y cómo se reparte el trabajo entre chips.
En una GPU NVIDIA, CUDA es la plataforma y el modelo de programación que permite escribir y ejecutar código paralelo, con bibliotecas que muchas herramientas de IA utilizan por debajo. Otras GPU y proveedores tienen sus propias plataformas. Esa diferencia influye en la portabilidad: una aplicación que ya depende de ciertas bibliotecas o kernels puede requerir trabajo para pasar a otro acelerador, aunque el marco de alto nivel anuncie soporte para ambos.
La TPU puede resultar atractiva para cargas grandes y regulares que aprovechan sus unidades matriciales y la interconexión de un pod. Una GPU puede encajar mejor cuando hacen falta más opciones de hardware, herramientas existentes o tipos de cálculo diversos. Son tendencias, no reglas: una GPU concreta puede superar a una TPU para un modelo dado, y una TPU puede ofrecer mejor coste o capacidad para otra carga.
-IA Crew dice: “Compatible con PyTorch” abre una puerta. No promete que el primer script cruce el umbral sin tocar una configuración.-
Qué elegir para un proyecto
Compara con la misma versión del modelo, precisión numérica, longitud de secuencia, tamaño de lote y volumen de solicitudes. Mide rendimiento en unidades útiles —por ejemplo, tokens por segundo o ejemplos procesados—, pero registra también latencia por petición, memoria, tiempo de preparación y coste total. Un pico de operaciones teóricas no predice por sí solo la respuesta que recibirá una persona.
En entrenamiento, observa cuánto tarda en llegar una métrica de calidad objetivo y cuánto cuesta la ejecución completa, incluidos los tiempos de compilación y los datos entre chips. En inferencia, distingue peticiones pequeñas de lotes grandes: la latencia que importa en un asistente interactivo no es igual al rendimiento agregado de un servicio que procesa miles de solicitudes por minuto.
La disponibilidad puede decidir antes que el silicio. Las TPU de Google Cloud se reservan como recursos de nube; una GPU puede estar en la nube, en un servidor propio o en un equipo de desarrollo. Revisar cuotas, región, precios, herramientas de depuración y soporte del equipo evita optimizar un modelo para un acelerador que no puedes obtener cuando lo necesitas.
-IA Crew dice: La hoja de especificaciones no paga la factura de la nube. El benchmark de tu carga, sí puede explicar por qué llegó.-
La elección razonable sale de una prueba reproducible, no de una pelea de siglas. Si el trabajo es matricial, el marco soporta bien el dispositivo y la escala está disponible, prueba TPU. Si la flexibilidad del software, la variedad de cálculos o el acceso al hardware pesan más, prueba GPU. En ambos casos, deja registrados modelo, configuración, precisión, coste y condiciones para que “más rápido” signifique algo concreto.
Diccionario de la Crew
ASIC — Circuito integrado de aplicación específica, diseñado para una función o familia de tareas específica.
TensorCore — Unidad dentro de una TPU que reúne recursos de cálculo matricial, vectorial y escalar; el diseño cambia según la generación.
XLA — Compilador de Google que transforma operaciones matemáticas para ejecutarlas en sus aceleradores.\nCUDA — Plataforma y modelo de programación de NVIDIA para ejecutar código en sus GPU.\nMXU — Unidad de multiplicación de matrices de una TPU de Google.
Arreglo sistólico — Organización de unidades de cálculo por la que los datos fluyen entre operaciones conectadas.
Compilador — Programa que transforma una descripción de operaciones en instrucciones adaptadas al hardware.
Rendimiento — Cantidad de trabajo completada por unidad de tiempo, medida para una carga concreta.