Qué es la destilación de modelos en IA y para qué sirve
La destilación entrena un modelo más pequeño con las salidas de otro más capaz. Así puede reducir memoria y coste, con límites que conviene medir.
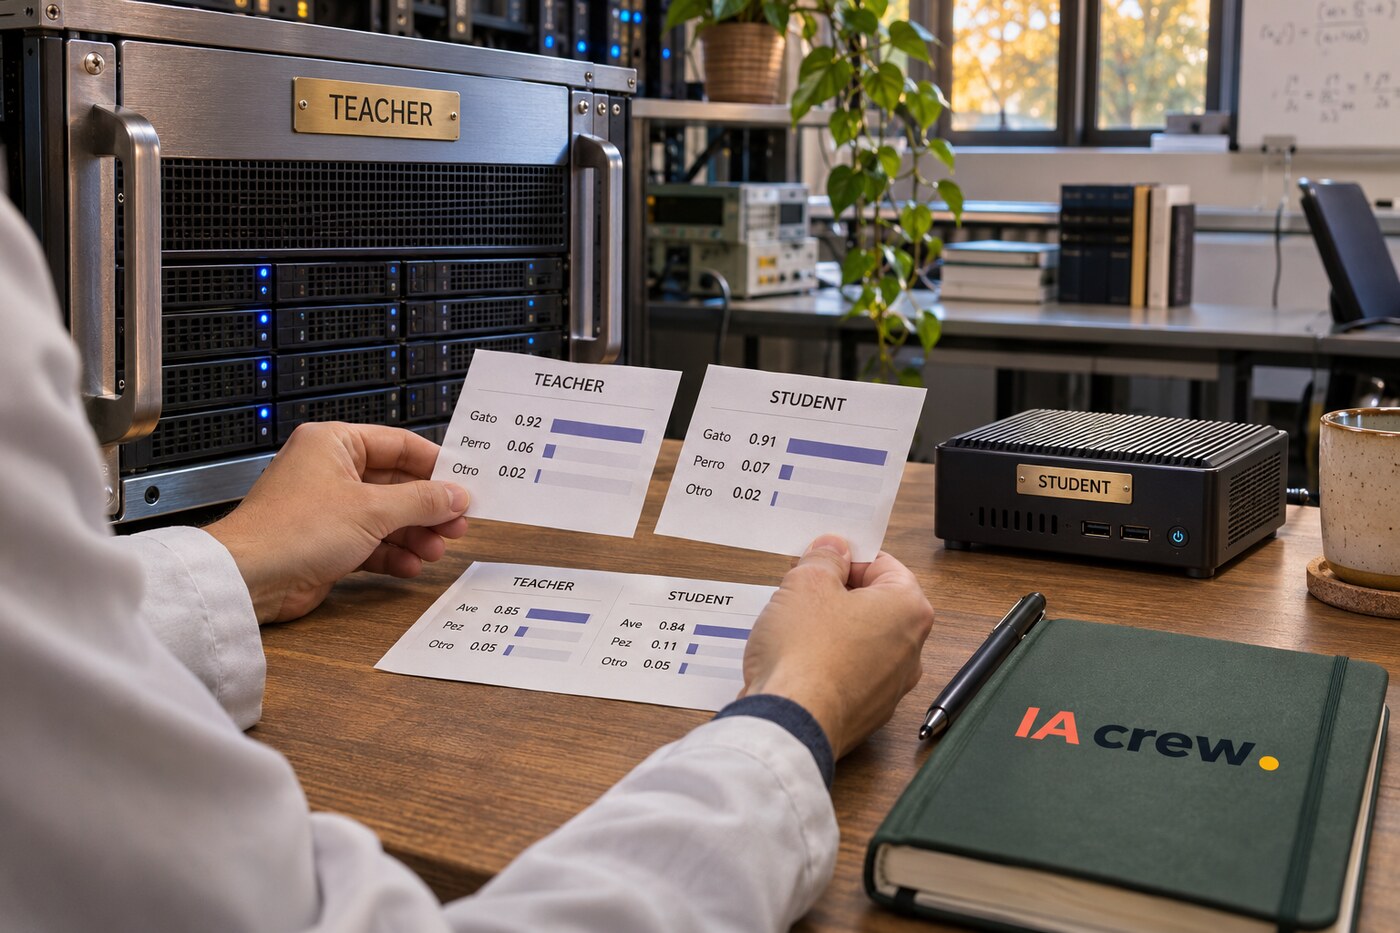
La destilación de modelos es una técnica de aprendizaje automático que enseña a un modelo más pequeño a reproducir parte del comportamiento de otro más capaz. Se usa para reducir memoria, coste o latencia al ejecutar una IA, aunque la transferencia no convierte al alumno en una copia perfecta del maestro: conserva unas habilidades mejor que otras y hay que medir cuáles.
El maestro no entrega sus pesos
En el esquema clásico, un modelo grande —el maestro— produce respuestas para ejemplos y un modelo más pequeño —el alumno— aprende de ellas. El alumno no recibe necesariamente los parámetros internos del maestro. Aprende de sus salidas, que pueden ser etiquetas, puntuaciones, probabilidades o respuestas completas, según el problema y el método.
La diferencia con el entrenamiento corriente se aprecia en un clasificador. Si una imagen muestra un gato, la etiqueta “gato” solo dice cuál es la respuesta correcta. El maestro puede aportar además una distribución que asigna, por ejemplo, más probabilidad a “lince” que a “camión”. Esa información sobre parecidos y dudas suele enseñar más que una única etiqueta dura.
En la propuesta clásica de Hinton, Vinyals y Dean, el alumno aprende a aproximar las probabilidades que produce el maestro. Una temperatura ajusta lo suaves que son esas probabilidades: al elevarla, hace más visibles alternativas que quedarían casi ocultas. No es un control mágico de calidad; es un recurso de entrenamiento que luego se suele ajustar o retirar para usar el modelo.
-IA Crew dice: Un profesor que solo dice “bien” o “mal” enseña menos que uno que explica en qué se equivocó el examen. La máquina tampoco necesita una toga; necesita señales útiles.-
Qué se transfiere en un modelo de lenguaje
En un LLM, la destilación puede tomar varias formas. El modelo mayor puede generar respuestas que luego se usan como ejemplos para ajustar el menor; también se pueden entrenar predicciones de tokens o comparar distribuciones internas cuando se tiene acceso a ellas. “Destilar” describe una familia de métodos, no un botón universal que reduzca cualquier modelo sin preparación.
Una ruta frecuente consiste en construir un conjunto de preguntas, pedir respuestas al maestro y entrenar al alumno con esos pares. Puede cubrir instrucciones, explicaciones o formatos de salida concretos. El valor depende de la selección: miles de ejemplos repetitivos producen un alumno repetitivamente seguro; los casos variados y revisados suelen dar una señal de aprendizaje más rica.
El alumno también puede aprender de respuestas generadas sin que cada ejemplo tenga una etiqueta humana, pero eso no vuelve confiable todo lo que dice el maestro. Si la respuesta contiene un error, una omisión o un sesgo, el conjunto puede transmitirlo. La destilación de respuestas hereda lo que se le ofrece; no incorpora por arte de magia una verificación independiente.
-IA Crew dice: Copiar una explicación falsa en un modelo más pequeño no la convierte en una verdad compacta. Solo hace que ocupe menos espacio.-
Para qué sirve y qué cuesta
El objetivo práctico suele ser bajar el coste de inferencia, es decir, de generar respuestas después del entrenamiento. Un modelo menor puede necesitar menos memoria y funcionar con más rapidez en un dispositivo o servicio limitado. Eso resulta útil si la aplicación no necesita cada capacidad del modelo más grande o si el volumen de consultas hace que el coste por respuesta importe.
La cuenta completa, sin embargo, incluye preparar los datos, generar las salidas del maestro, entrenar y evaluar al alumno. La destilación puede ahorrar dinero al servir muchas consultas y aun así salir cara para una prueba pequeña. Si el modelo original ya es barato, o el alumno pierde justo la capacidad necesaria, la operación añade trabajo sin una ventaja que el usuario note.
Tampoco equivale a cuantización. La cuantización representa los pesos con menos precisión para reducir memoria y acelerar ciertas operaciones; la destilación entrena un modelo para aproximar otro. Se pueden combinar, pero resuelven partes distintas del problema. Podar parámetros o usar una arquitectura compacta también son opciones diferentes, con sus propios compromisos.
Cómo saber si la versión pequeña compensa
No basta con comparar el número de parámetros. Conviene probar tareas reales, casos difíciles, idiomas y formatos que el producto usará, y medir precisión junto con tiempo, memoria y coste. Un resultado agregado puede ocultar una caída seria en una tarea minoritaria; una demo fluida puede ocultar respuestas incorrectas cuando cambia el tipo de pregunta.
También importa el conjunto de datos. Si las salidas del maestro incluyen información privada, texto con derechos o contenido inseguro, transferirlas exige revisar permisos y filtros igual que cualquier otro material de entrenamiento. Y si se emplea un modelo comercial como maestro, sus condiciones de uso pueden limitar cómo se reutilizan sus respuestas o el modelo resultante.
-IA Crew dice: “Es más pequeño” describe el archivo. “Sirve igual” es una afirmación de producto y necesita pruebas por separado.-
La destilación funciona mejor como una decisión de ingeniería con un objetivo acotado: qué tareas debe conservar el alumno, qué pérdida es aceptable y dónde se ejecutará. Cuando esas condiciones están medidas, un modelo compacto puede ser una alternativa sensata. Sin ellas, solo se ha cambiado un modelo grande por otro más pequeño que quizá falle con más eficiencia.
Diccionario de la Crew
Maestro — Modelo cuyas salidas se usan como señal para entrenar otro modelo.
Alumno — Modelo entrenado para aproximar capacidades o respuestas del maestro.
Temperatura — Parámetro que modifica la distribución de probabilidades para hacer más o menos visibles alternativas.
LLM — Modelo de lenguaje de gran tamaño entrenado para predecir o generar secuencias de tokens.
Inferencia — Uso de un modelo ya entrenado para producir una predicción o respuesta.
Cuantización — Representación de los pesos con una precisión numérica menor para reducir memoria o acelerar cálculos.
Fuentes
Hinton, Vinyals y Dean — Distilling the Knowledge in a Neural Network