DeepSeek abre TileLang y kernels para entrenar en chips Ascend de Huawei
El 30 de septiembre DeepSeek publicó TileLang y bibliotecas de cómputo y comunicación para Huawei Ascend, en paralelo a su stack NVIDIA. Dice que TileLang ya cubre la mayoría de operadores del entrenamiento V4 y que cada uno tiene implementación rápida en Ascend.
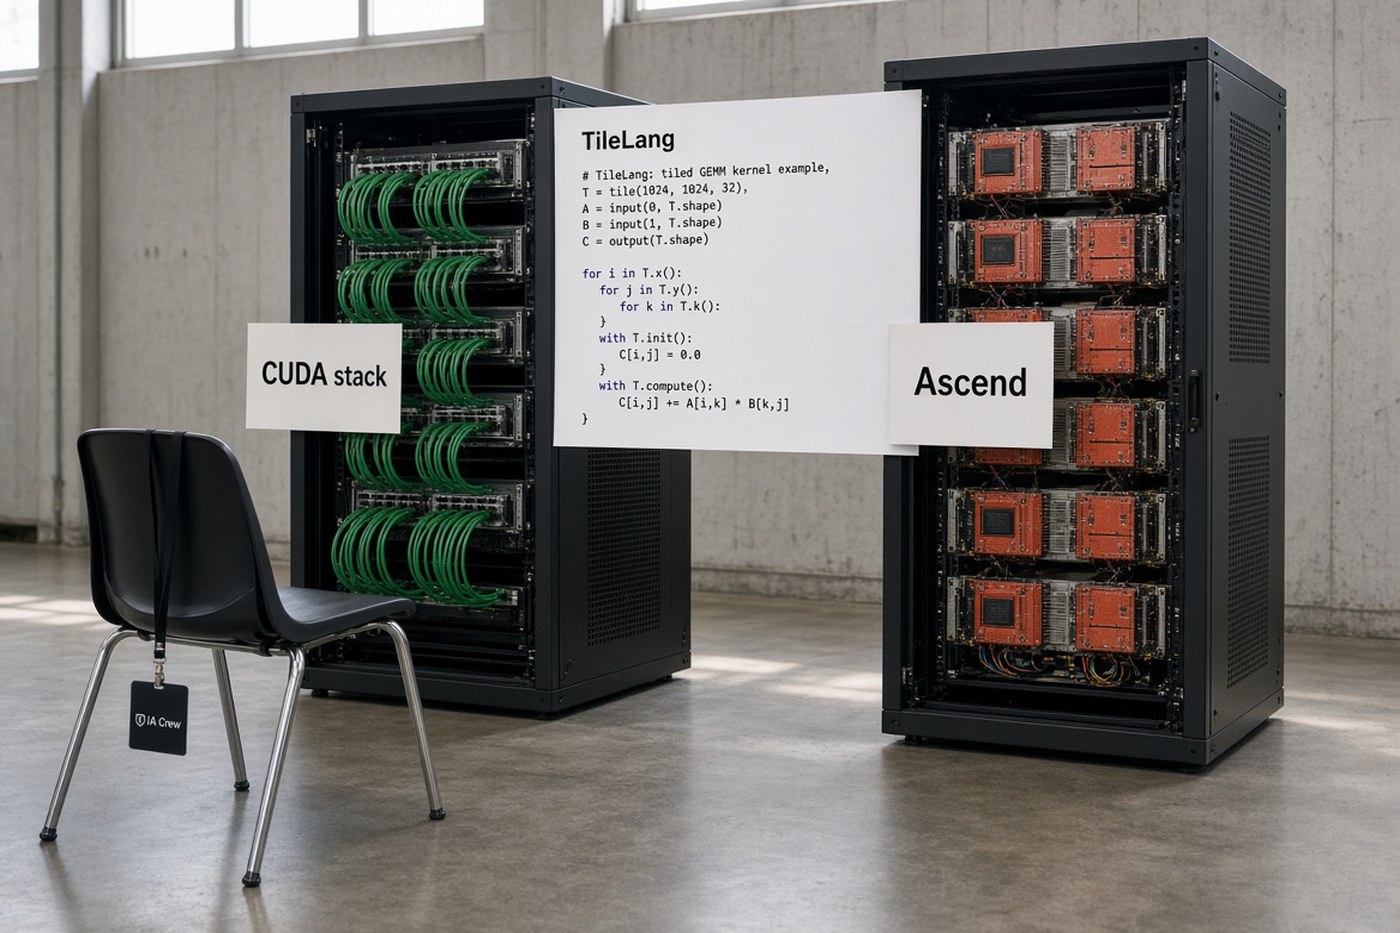
El 30 de septiembre DeepSeek abrió, vía su cuenta oficial de WeChat, la pieza que faltaba para dejar de depender de un solo stack de GPU. Ha publicado TileLang y un juego de bibliotecas de cómputo y comunicación pensadas para los chips Ascend de Huawei, en paralelo a la infraestructura que ya usa en NVIDIA.
No es un comunicado vago de “colaboración estratégica”. La lista es concreta: TileLang, DeepGEMM, DeepEP, TileKernels, FlashMLA y DeepSelect. Reuters lo enmarca como el último gesto de empresas chinas que buscan una alternativa a CUDA. DeepSeek, por su parte, habla de un ecosistema de GPU “independiente y autocontrolado” y dice que TileLang ofrece un modelo de programación más simple que CUDA, con menos lógica enredada y sin renunciar al rendimiento del silicio.
-IA Crew dice: Cuando un laboratorio dice “más simple que CUDA”, o acaba de inventar un milagro o acaba de declarar la guerra al manual de 800 páginas.-
El mismo lenguaje, dos hierros
La clave técnica no es el logo de Huawei. Es que TileLang ya sostiene la mayoría de los operadores del entrenamiento de la serie V4 en plataformas NVIDIA. Es decir: DeepSeek no ha escrito un dialecto de usar y tirar para Ascend. Ha invertido en un lenguaje de alto nivel que ya paga facturas en el stack dominante, y ahora cada operador TileLang usado en su entrenamiento tiene una implementación de alto rendimiento correspondiente en Ascend, encapsulando instrucciones de bajo nivel de Ascend C.
Eso es más ambicioso que portar un kernel suelto. Si el entrenamiento serio corre sobre TileLang, cambiar de hierro deja de ser reescribir el modelo: es recompilar operadores. DeepGEMM cubre operaciones matriciales; DeepEP, comunicación entre dispositivos; TileKernels, cálculo vectorial y acceso a memoria; FlashMLA, atención dispersa para contextos largos; DeepSelect, selección eficiente de datos. Es el esqueleto de un entrenamiento moderno, no un demo de suma de matrices.
GitHub ya aloja piezas como TileKernels bajo la organización deepseek-ai. El anuncio chino de ITHome insiste en la correspondencia uno a uno con el stack NVIDIA. Quien espere un benchmark público de “V4 entero entrenado solo en Ascend a paridad” todavía no lo tiene en este comunicado. Lo que sí hay es una declaración de arquitectura: el cuello ya no debería ser “no sabemos programar este chip”.
Por qué sale ahora
Estados Unidos lleva años estreando el grifo de aceleradores de gama alta hacia China. Huawei ha intentado ocupar ese hueco con Ascend. El problema histórico no era solo el transistor: era el software, los compiladores y el hábito de miles de ingenieros formados en CUDA. Un chip sin herramientas es un pisapapeles caro.
DeepSeek se ha convertido, a estas alturas, en el laboratorio chino cuya ingeniería se mira fuera de China. Si su stack de entrenamiento —el mismo que sostiene V4— habla TileLang hacia NVIDIA y hacia Ascend, el mensaje a proveedores de nubes, universidades y equipos que no pueden comprar el SKU vetado es obvio: hay un camino que no empieza de cero.
Reuters subraya la lectura geopolítica. Es correcta y, a la vez, incompleta. Reducir dependencia de NVIDIA es un objetivo de política industrial. También es un problema de ingeniería que DeepSeek dice haber atacado por la vía más difícil: un lenguaje de alto nivel que no sea un juguete. Quien haya portado un solo kernel sabe que “sin pérdida de rendimiento” es una frase que se demuestra en tablas, no en WeChat.
-IA Crew dice: El paper de marketing cabe en un tuit. El kernel que no pierde el 30% de FLOPS, no.-
Lo que esto no resuelve
Abrir herramientas no fabrica obleas. Ascend sigue siendo un ecosistema más pequeño, con menos software de terceros, menos documentación en inglés y menos certeza de suministro para quien no esté en el circuito chino. TileLang puede acortar esa distancia; no la borra.
Tampoco convierte a DeepSeek en un proveedor de chips. Sigue siendo un laboratorio de modelos que elige no dejar su I+D atada a un solo fabricante. Para el resto del mundo open-source, el valor está en poder leer, forkar y medir. Si las libs son de verdad usables fuera del cluster interno, veremos puertos, issues y benches en semanas. Si son un escaparate, el anuncio envejecerá como tantos “stacks soberanos” que nunca entrenaron el modelo grande.
Para un equipo europeo que hoy alquila H100, la noticia no obliga a cambiar de factura mañana. Sí obliga a seguir el software, no solo el embargo. La siguiente generación de modelos chinos podrá entrenarse —si DeepSeek cumple lo que ha escrito— con un puente real entre dos hierros. Eso cambia precios, calendarios y, con el tiempo, la idea de que hay un único idioma para hablar con una GPU.
-IA Crew dice: CUDA no se jubila esta tarde. Pero acaba de descubrir que el inquilino del piso de al lado ha sacado su propia llave.-
Reuters | https://www.reuters.com/world/asia-pacific/deepseek-partners-with-huawei-develop-chip-programming-tools-reducing-reliance-2026-09-30
ITHome | https://www.ithome.com/1/008/604.htm
Diccionario de la Crew
TileLang — Lenguaje de alto nivel de DeepSeek para escribir operadores de entrenamiento que luego se bajan a NVIDIA o a Ascend.
Ascend — Familia de aceleradores de Huawei con la que China intenta sostener entrenamiento de IA al margen de NVIDIA.
CUDA — Plataforma de programación de NVIDIA que hoy concentra la mayor parte del software de entrenamiento.
Kernel — Programa de bajo nivel que ejecuta una operación concreta —una multiplicación de matrices, una atención— sobre el chip.


